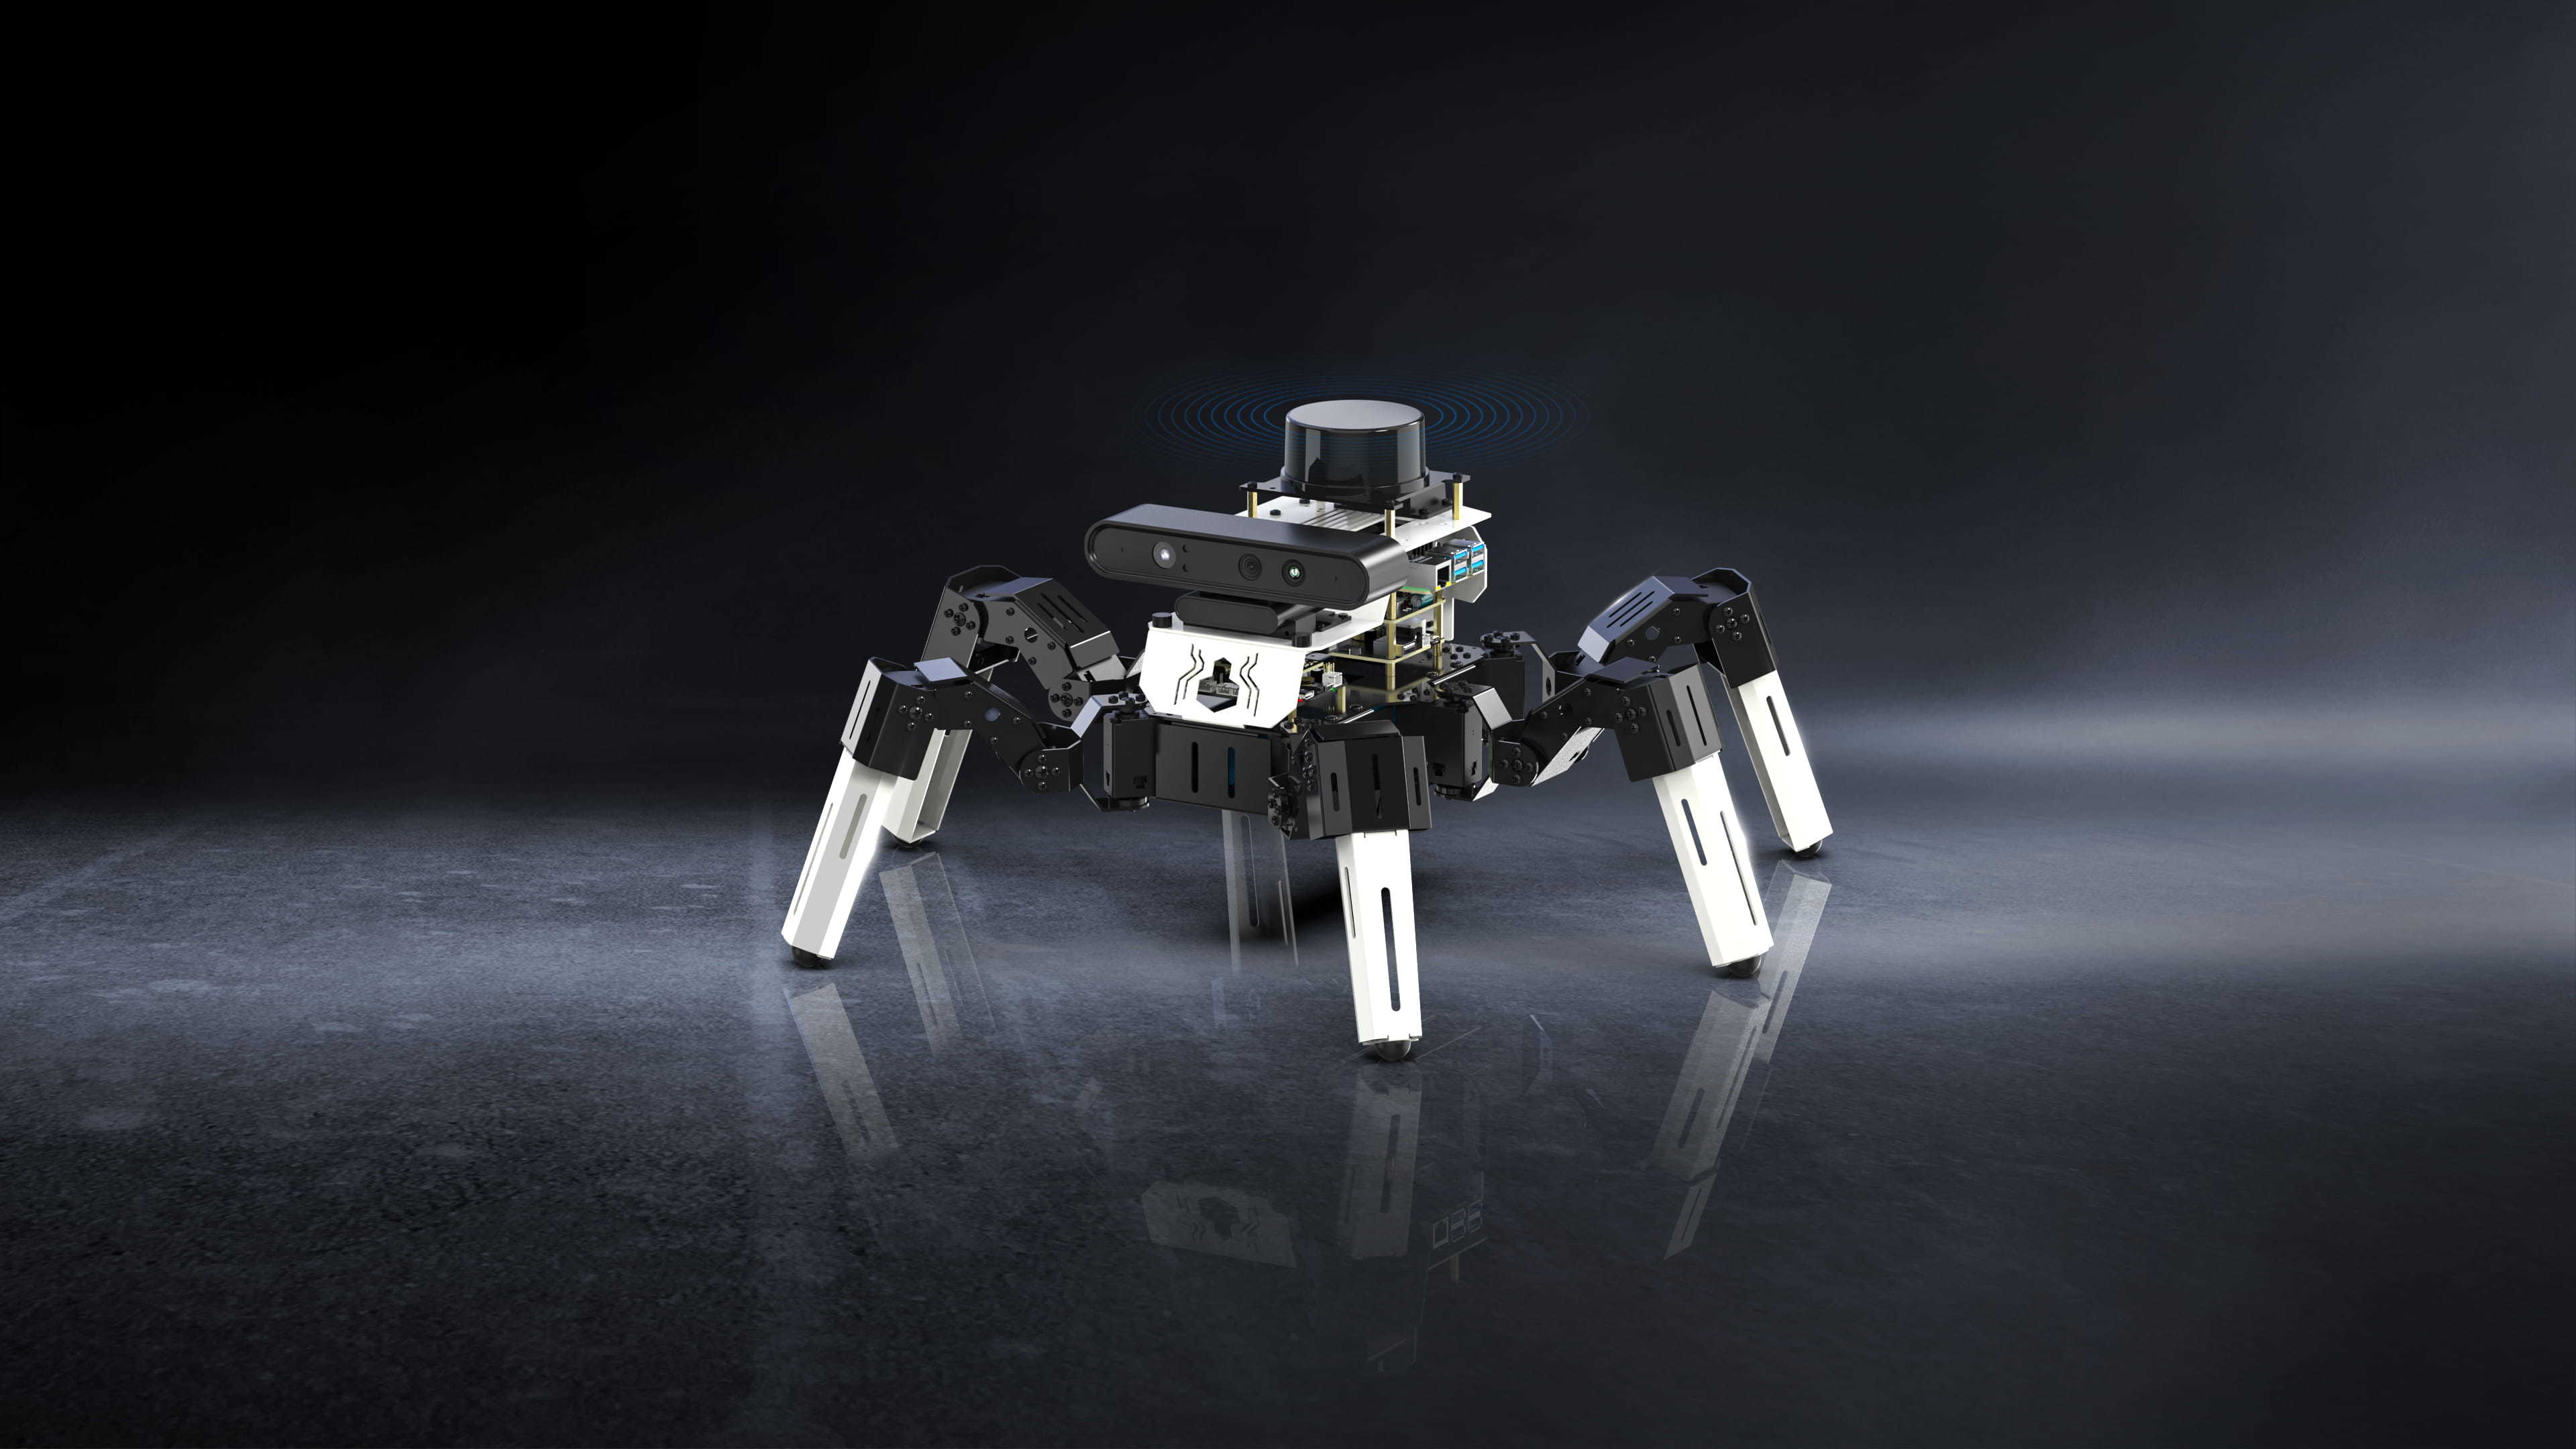


支持选配思岚A1或YDLIDAR 4ROS,思岚A1适合室内小场景使用,YDLIDAR 4ROS满足室内外大场景高精度使用,两种不同的激光雷达可满足不同场景下的SLAM建图导航避障。


MUTORS实时接入通义千问大模型平台,宛如配备"超级大脑",不仅能理解文本指令,还能灵活应答。
MUTO RS搭载AI大模型语音模块和扬声器.支持语音与文字实时互转,接入通义千问后,能"听"会"说",实现智能交互体验。
MUTO RS搭载深度相机,能够理解和分析图像内容,精准识别物体,并输出文本和语音反馈。


基于大模型的语义理解能力,MUTO RS能够解析用户的语音指令,并执行对应的动作,实现自然流畅的语音控制。
通过大模型与深度相机的协同工作,MUTO RS具备环境理解与距离感知能力,能够结合视觉识别内容与距离数据进行智能问答。
借助视觉大模型的强大分析能力,MUTO RS能够在复杂环境中自动识别并跟随目标物品。
通过视觉大模型的深度分析,MUTO RS能够精准识别并实时追踪不同颜色的线条,实现自主巡航。


通过视觉大模型分析,MUTO RS能够深入理解地图不同区域内的物品、空间布局。
MUTO RS可以实时回传环境数据至视觉大模型进行深度分析,并根据用户不同的语音指令自适应动态路径规划,自主导航至单个或多个指定区域,从而实现智能多点导航。
通过语音大模型推理和视觉大模型分析,MUTO RS能够精准识别并分析用户的语音指令深层次理解指令含义并自主规划完成对应搜索任务。


通过融合视觉理解、语义分析与SLAM动态路径规划,MUTO RS能够拆解用户下达的复杂指令实时感知环境变化,并完成识别、追踪、导航、问答等一系列连贯操作。
通过扩展知识库实现用户意图识别与环境情境分析,无需发布详细的指令,机器人即可自行理解用户的潜在需求,自主进行任务规划与动态响应。


MUTO RS六足机器人可选配高性能TOF激光雷达或三角测距雷达,支持多种建图算法与智能路网规划,具备单点/多点导航功能,可精准感知周围障碍物,实现动态避障、警卫、巡逻、跟随等功能。
3D结构光深度相机可生成深度图像和点云数据,精准获取目标物体的深度信息,实现距离的精确测算。结合雷达数据,可构建高精度三维彩色地图,支持更精准的环境感知与智能导航。
集成多种主流图像处理算法,支持OpenCV、MediaPipe等框架,可高效识别多种目标物体,助力开发者快速构建高性能计算机视觉应用。
将视觉算法与机器人运动控制相结合,MUTO RS六足机器人能够实现多种基于视觉的人机交互功能,如KCF物体追踪、颜色追踪、二维码指令控制,解锁更多应用场景。
MUTO RS六足机器人搭载高性能AI大模型语音模块,支持离线语音指令识别,无需联网即可语音控制机器人运动、视觉巡线、颜色识别、颜色追踪,赋予机器人"能听能答"的交互能力。
支持多台机器人同地图多点导航巡航与动态避障,可通过一台主机同步控制多台机器人,实现多机同步控制。


MUTO RS旗舰版六足机器人支持手机APP遥控,可以通过手机APP控制机器人运动方向,支持表演模式、全屏控制、数据监测、机器人校准、动作表演等功能。
